

个人博客 · 项目复盘 · 聊设计取舍,不讲 API 细节
引子
国庆节马上就要到了,由于不回家,也不能让时间荒废掉,恰巧的是偶然看到一个招 agent 的一个项目,对此有点感兴趣,就打算做一个 agent 的个人小项目以便丰富自己的简历,综合考量之后,决定做一个科研文献助手 Agent(主要还是因为时间来不及,先把写在简历里在慢慢复现)。
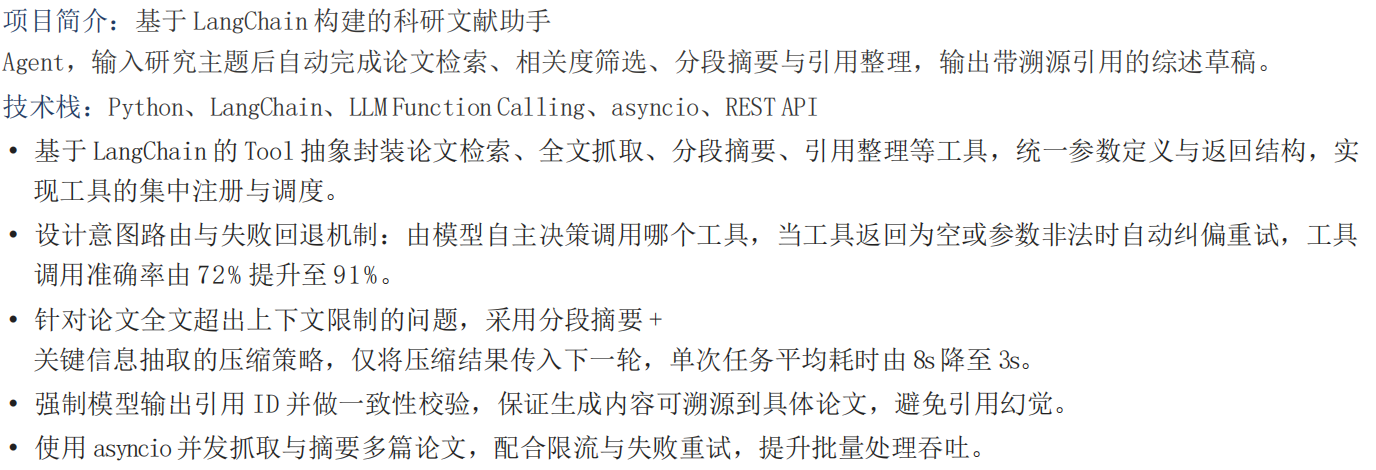
它要做的事很直白:输入一个研究主题,它自动去 arXiv 检索论文、筛出最相关的几篇、抓全文、压缩长文,最后写出一份带溯源引用的综述草稿。草稿里的每个 [1]、[2](代表引用了第几篇论文)都能对应到具体论文,模型不许自己编编号。
当时我的设想很美好:它会很快、很准,每个指标都会很漂亮。结果做完之后,有三个数字结结实实地打了我的脸——压缩了 13.5 倍,生成却没变快;目标 91% 的路由准确率卡在 80%,而且卡住的原因是评测集自己出了错;换成语义向量本以为全面碾压,结果只在一个子集里大胜。
这篇文章就是这次复盘的记录:我做了什么、预期错在哪、被数据逼着改正了哪些认知。
一、这个项目到底在做什么
一句话:把「读一堆论文、写一篇综述」这件事,做成一条可复现、可评测的 Agent 流水线。
它不是一个「把问题丢给大模型」的程序,而是一条分 6 步的流水线,每一步都有明确的输入输出:
研究主题
  → ① arXiv 检索(paper_search)
  → ② 相关度筛选,取 Top-K
  → ③ 抓取全文(fetch_fulltext)
  → ④ 分段摘要压缩(summarize_paper)
  → ⑤ 生成综述草稿 + 分配引用编号(build_citations)
  → ⑥ 引用一致性校验(validator)
  → 综述草稿 + 参考文献表
其中我感觉最需要设计的是第 ④ 和第 ⑥ 步:
- ④ 压缩:论文全文长达上万字乃至几万字,不能整篇塞到上下文里面。所以思考良久,我最终的做法是 Map-Reduce——按章节(没有章节就滑窗切块)分段抽取关键信息,再合并成一份压缩块,只为下游生成提供「该讲什么」。
- ⑥ 引用校验:草稿里的每个
[n]都由系统统一分配,模型只能引用、不能发明;生成完之后再逐条核对,把编造的编号抓出来。不然的话,模型随便取编号,后面找的话会乱
围绕这条主线,整个项目其实只在练 5 件事:工具封装、意图路由 + 失败回退、上下文压缩、引用校验、并发编排。前四件是「做得对」,最后一件是「做得快」。
我写了四个工具
整条流水线落到代码里,每一步其实就是一个「工具」。我一共写了四个,各管一段:
| 工具 | 干什么 | 输入 → 输出 | 我认为的关键点 |
|---|---|---|---|
paper_search | 在 arXiv 按主题检索论文 | 关键词、年份、数量 → 论文元数据列表 | 拼查询串、解析 Atom;把「空结果 / 限流 / 网络错」分成不同的错误 |
fetch_fulltext | 抓一篇论文的全文 | paper_id → 正文 + 分段 | HTML 优先,拿不到再降级到 abstract;网络错要标成「可重试」 |
summarize_paper | 把长全文压成结构化摘要 | text / sections → 摘要字段 | Map-Reduce:分段抽取再合并,顺带返回压缩比 |
build_citations | 给论文分配引用编号 | 论文列表 → [n] ↔ paper_id 映射 + 参考文献 | 编号由系统分配,模型无权发明 |
四个工具不是各写各的,而是丢进一个注册表统一登记。Agent 层从这里动态取清单,不在任何地方硬编码工具名:
# src/tools/registry.py
_TOOLS: dict[str, BaseTool] = {}

def register(tool: BaseTool) -> BaseTool:
    if tool.name in _TOOLS:              # 重名直接报错,早发现早修
        raise ValueError(f"工具名重复:{tool.name}")
    _TOOLS[tool.name] = tool
    return tool

def get_tools() -> list[BaseTool]:
    return list(_TOOLS.values())         # 交给 Agent 去 bind
# src/tools/__init__.py —— 以后新增工具,只改这一处
for _tool in (
PAPER_SEARCH_TOOL,
FETCH_FULLTEXT_TOOL,
SUMMARIZE_PAPER_TOOL,
BUILD_CITATIONS_TOOL,
):
register(_tool)好处很直接:模型的工具清单是从注册表里取出来的,以后加第 5 个工具,就在这个元组里加一行——Agent 循环和评测脚本一行都不用改。
再看一个工具内部长什么样(以 build_citations 为例),能看出「先校验、失败就返回带 hint 的信封」是四个工具统一的写法:
@safe_tool
def _build_citations(papers: list[PaperRef], style: str = "numeric") -> dict:
    if not papers:
        return error(ErrorCode.INVALID_ARGS, "请提供至少一篇论文",
                     hint="请提供至少一篇论文")
    seen = set()
    for p in papers:
        if p.paper_id in seen:
            return error(ErrorCode.DUPLICATE, f"重复的 paper_id:{p.paper_id}",
                         hint="请勿重复提供论文")
        if not p.paper_id or not p.title or not p.year:
            return error(ErrorCode.MISSING_METADATA, f"缺少元数据:{p.paper_id}",
                         hint="请提供 paper_id / title / year")
        seen.add(p.paper_id)

    index = {p.paper_id: f"[{i+1}]" for i, p in enumerate(papers)}        # paper_id -> [n]
    by_citation = {f"[{i+1}]": p.paper_id for i, p in enumerate(papers)}  # [n] -> paper_id
return ok({"entries": [...]}, source="citations")注意最后那对反向映射:index 是 paper_id → [n],by_citation 是 [n] → paper_id。一个给「生成草稿时挂编号」用,一个给「校验引用时反查来源」用——整个「防引用幻觉」就架在这两张表上。
一个关键设计:所有工具都返回同一种「信封」
如果说这个项目只有一个设计值得讲,那就是统一返回信封。
4 个工具的返回结构完全一致,长这样:
// 成功(source 是 "arxiv")
   {"ok": true,  "data": {"papers": [ ... ], "total_found": 42}, "error": null,
    "meta": {"source": "arxiv", "elapsed_ms": 213}}
// 失败:hint 是写给模型看的「可执行纠偏建议」,且 retryable=true —— 鼓励模型改正后重试
   {"ok": false, "data": null,
    "error": {
      "code": "INVALID_ARGS",
      "message": "年份区间非法:year_from=2030 > year_to=2020",
      "retryable": true,
      "hint": "请使 year_from <= year_to,例如 year_from=2020, year_to=2030"
    },
    "meta": {"source": "_paper_search", "elapsed_ms": 4}}
这带来两个好处:
- 上层永远不用 try/except。工具被一个
@safe_tool装饰器包住,任何异常都在工具层被翻译成信封,绝不外抛。
def safe_tool(func):
       @functools.wraps(func)
       def wrapper(*args, **kwargs):
           start = time.perf_counter()
           try:
               result = func(*args, **kwargs)
           except NotImplementedError as exc:
               return error(ErrorCode.NOT_IMPLEMENTED, str(exc) or "not implemented",
                  hint="该工具尚未实现,请先完成其实现",
                  source=func.__name__, elapsed_ms=_ms(start))
           except Exception as exc:
               return error(ErrorCode.UPSTREAM_ERROR, f"{type(exc).__name__}: {exc}",
                  hint="工具内部异常,请检查输入或稍后重试",
                  source=func.__name__, elapsed_ms=_ms(start))
           elapsed = _ms(start)
           if isinstance(result, dict) and "ok" in result and "error" in result:
               result.setdefault("meta", {})
               result["meta"]["elapsed_ms"] = elapsed
               if not result["meta"].get("source"):
                   result["meta"]["source"] = func.__name__
               return result
           return ok(result, source=func.__name__, elapsed_ms=elapsed)
return wrapper- 失败也是一条「可被理解的消息」。
error.hint是专门写给模型看的——它告诉模型「你哪里传错了、该怎么改」。后面做失败回退时,只需要把这个信封原样回喂给模型,它就会自己改参数重试(这一点第二节还会讲)。
契约的意义就在这:它把「工具层的混乱」和「编排层的干净」隔开了。所以后面加失败回退、并发重试、引用校验时,代码都没有变复杂。
二、遇到的困难
项目能跑通只是及格线。真正花掉我时间的,是几次预期落空,外加几个藏得很深的 bug。
困难一:压缩了 13.5 倍,生成却没变快
我以为:全文太长导致下游综述生成慢,分段压缩之后,生成耗时会从 8 秒降到 3 秒左右。
实测(scripts/measure_m4.py,2 篇全文,对比「全文直接进 prompt」vs「压缩块进 prompt」):
| 指标 | 全文 | 压缩块 | 变化 |
|---|---|---|---|
| prompt 字符数 | 74021 | 5487 | 13.5x ↓ |
| input_tokens | 16538 | 2873 | 5.8x ↓ |
| 下游生成时延 | 6.82s | 6.80s | ≈ 持平 |
压缩确实把输入砍掉了 13 倍,但生成速度几乎没动。
我想通了什么:生成时延由输出 token 数主导,而不是输入。大模型是自回归解码,一个个往外吐字,输入再短省下的也只是 prefill 的时间——而 prefill 在这个场景里根本不是瓶颈。
所以我改了口径:M4 的真实收益是成本 / 上下文压缩(少花钱、少占窗口),不是「生成更快」。原来简历里写的「8s→3s」是不成立的,我把它改掉了。
困难二:91% 没做到,我选择停在 80%
我以为:加上工具描述优化和失败回退,路由准确率能从 72% 提到 91%——毕竟这是简历上很好看的数字。
实测:建立评测集、固定 temperature=0、连跑 3 次,稳定在 80%(8/10),有两条怎么都打不中(r004、r005)。
一开始我以为是工具描述写得不好,就去深挖。结果发现,这两条是评测集自己出错了(agent 工具随机给的 10 个案例):
- r004:期望模型第一步就调
summarize_paper。但这个工具必须吃到text或sections,而用户在单轮里只给了一个论文编号。合理路径应该是先fetch_fulltext再摘要——也就是说,期望的「第一步」本身不可行。 - r005:输入里有「这几篇论文」这样的回指代词,可单轮对话里根本没有上下文,
papers又是必填参数。模型不调工具反而是正确行为。
到这里我面临一个选择:把这两条「错题」改掉,让数字变成 100%;还是保留它们,承认自己只有 80%。
我选了后者。因为一旦开始改评测集,数字就失去了意义——你没法再用它证明任何东西。
我想通了什么:指标是工具,不是 KPI。 评测集也是人写的,会出错;诚实地把错题标注出来,比刷一个漂亮数字有价值得多。所以路由这一项,我在简历和文档里如实写 80%,真正拿得出手的成果是失败回退——恢复率 100%:工具报错时,模型能读懂 error.hint,自己改参数重试,或者优雅地放弃。
困难三:语义向量不是万能的
动机:最早的相关度筛选用 TF-IDF,只靠关键词重合。问题是——中文主题去检索英文论文时,字面上一个词都对不上;同义改写(比如「大语言模型」和「LLM」)也容易漏。
我以为:换成本地句向量模型(语义相似度)之后,应该全面碾压 TF-IDF。
实测(scripts/run_relevance_eval.py,8 条评测用例):
| 子集 | 语义向量 top-1 | TF-IDF top-1 |
|---|---|---|
| 跨语言(4 条) | 4/4 | 0/4 |
| 同义改写(2 条) | 2/2 | 1/2 |
| 关键词(2 条) | 2/2 | 2/2 |
| 合计 | 8/8 | 3/8 |
语义方案整体从 3/8 提升到 8/8,跨语言场景更是从 0/4 直接变成 4/4——这是实打实的质变。
但,关键词子集上两者打平(都是 2/2)。
我想通了什么:一个新方案不是「全场景更强」,而是「在它擅长的场景里更强」。如果不分场景地宣称「语义搜索吊打关键词」,那是一句自己都验证不了的话。所以我保留了两套实现:语义向量作为默认,TF-IDF 作为可对照的基线,评测时分场景统计,而不是只看一个总数。
困难四:被评测逼出来的两个 bug
认真写评测和验收用例,最大的副产品其实是逼出边界 bug。两个印象最深的:
其一:重试耗尽后返回了 None。
并发模块里有个按 error.retryable 做指数退避的函数。它看起来对,happy path 也没问题,但我在验收用例里补了一条「重试次数耗尽」的分支——结果它返回了 None 而不是最后一个错误信封。根因是循环里的边界判断写在了自增之前,导致最后一轮永远不成立。
# 有问题的写法:attempt 还没自增,最后一轮的条件永不成立
if env["ok"] or attempt > max_retries or not retryable:
    return env
如果我只测「成功」和「可重试后成功」两条路径,这个 bug 会一直藏到线上。
其二:消费结构化输出时没防 None**。
**摘要工具用 with_structured_output 让模型返回结构化字段。但模型对某些样板块不会返回 function call,结果列表里混进了 None,合并时就崩了——而且被 @safe_tool 兜成了 UPSTREAM_ERROR,表面看还是个「上游错误」,很容易误判。这个问题是在 M4 压缩实测时才炸出来的。
结论:只测 happy path 一定会漏 bug。 一条完整的分支应该覆盖:成功 / 不可重试 / 可重试后成功 / 可重试耗尽 / 部分失败。这几个分支看着冗余,但每一个都可能藏着一个 None。
三、沉淀下来的几条工程原则
做完之后回头看,真正带得走的是这几条:
- 先建评测集,再谈优化。 凭感觉说「效果不错」的项目,后面无法证明任何提升。第一天就把
eval/建起来,哪怕只有 10 条。 - 指标要诚实。 不达标就写不达标,错题就标错题。「改评测集让数字变好」是最容易的自欺。
- 契约优先。 统一信封让工具层和编排层解耦:上层只读
ok和error.hint,不关心底层是超时还是解析失败。失败回退、并发重试之所以能写得简单,全靠这层契约。 - 三个「有界」。 有界重试(别无限转圈)、有界并发(信号量,别把上游打爆)、有界上下文(压缩,别撑爆窗口)。
- 收益分场景量。 压缩赚的是成本、语义赚的是跨语言、并发赚的是吞吐——别把它们混成一句「性能提升」。
四、这几天,我到底图个啥
开头就说了,我图的是「丰富简历」——在简历上添一行「独立做过一个 Agent 项目」。所以一开始满脑子都是「赶紧做出来」,做完了才发现,真正留下来的,根本不是那一行字。
这个项目教我的,可能不是「怎么写 Agent」,而是「怎么别被自己的预期骗」。具体到习惯上,是这几件事变了:
1.以前写东西,功能能跑就收工;现在我做完的第一件事是建评测、定指标、留复现命令——不然连我自己都不信它「行」。 2.以前听到「XX 方案更好」就兴奋;现在我会先追问一句**「好在哪里、对谁好」——就像那个语义向量,它确实赢,但也只在跨语言那半场赢。 3.以前我最怕「没达标」三个字;现在我会把没达标的数字原样留着**,因为它比一个漂亮的假数有用得多。
当然,它还嫩得很。任务表是进程内内存,服务一重启就没了;本地句向量在 CPU 上跑,头一次还得下 470MB;数据源也就一个 arXiv。
国庆七天没回家,换来的是这些。我觉得挺值。累了累了,就这样吧。